
Klasszikus láncreakció okozta a pénteki Microsoft leállást
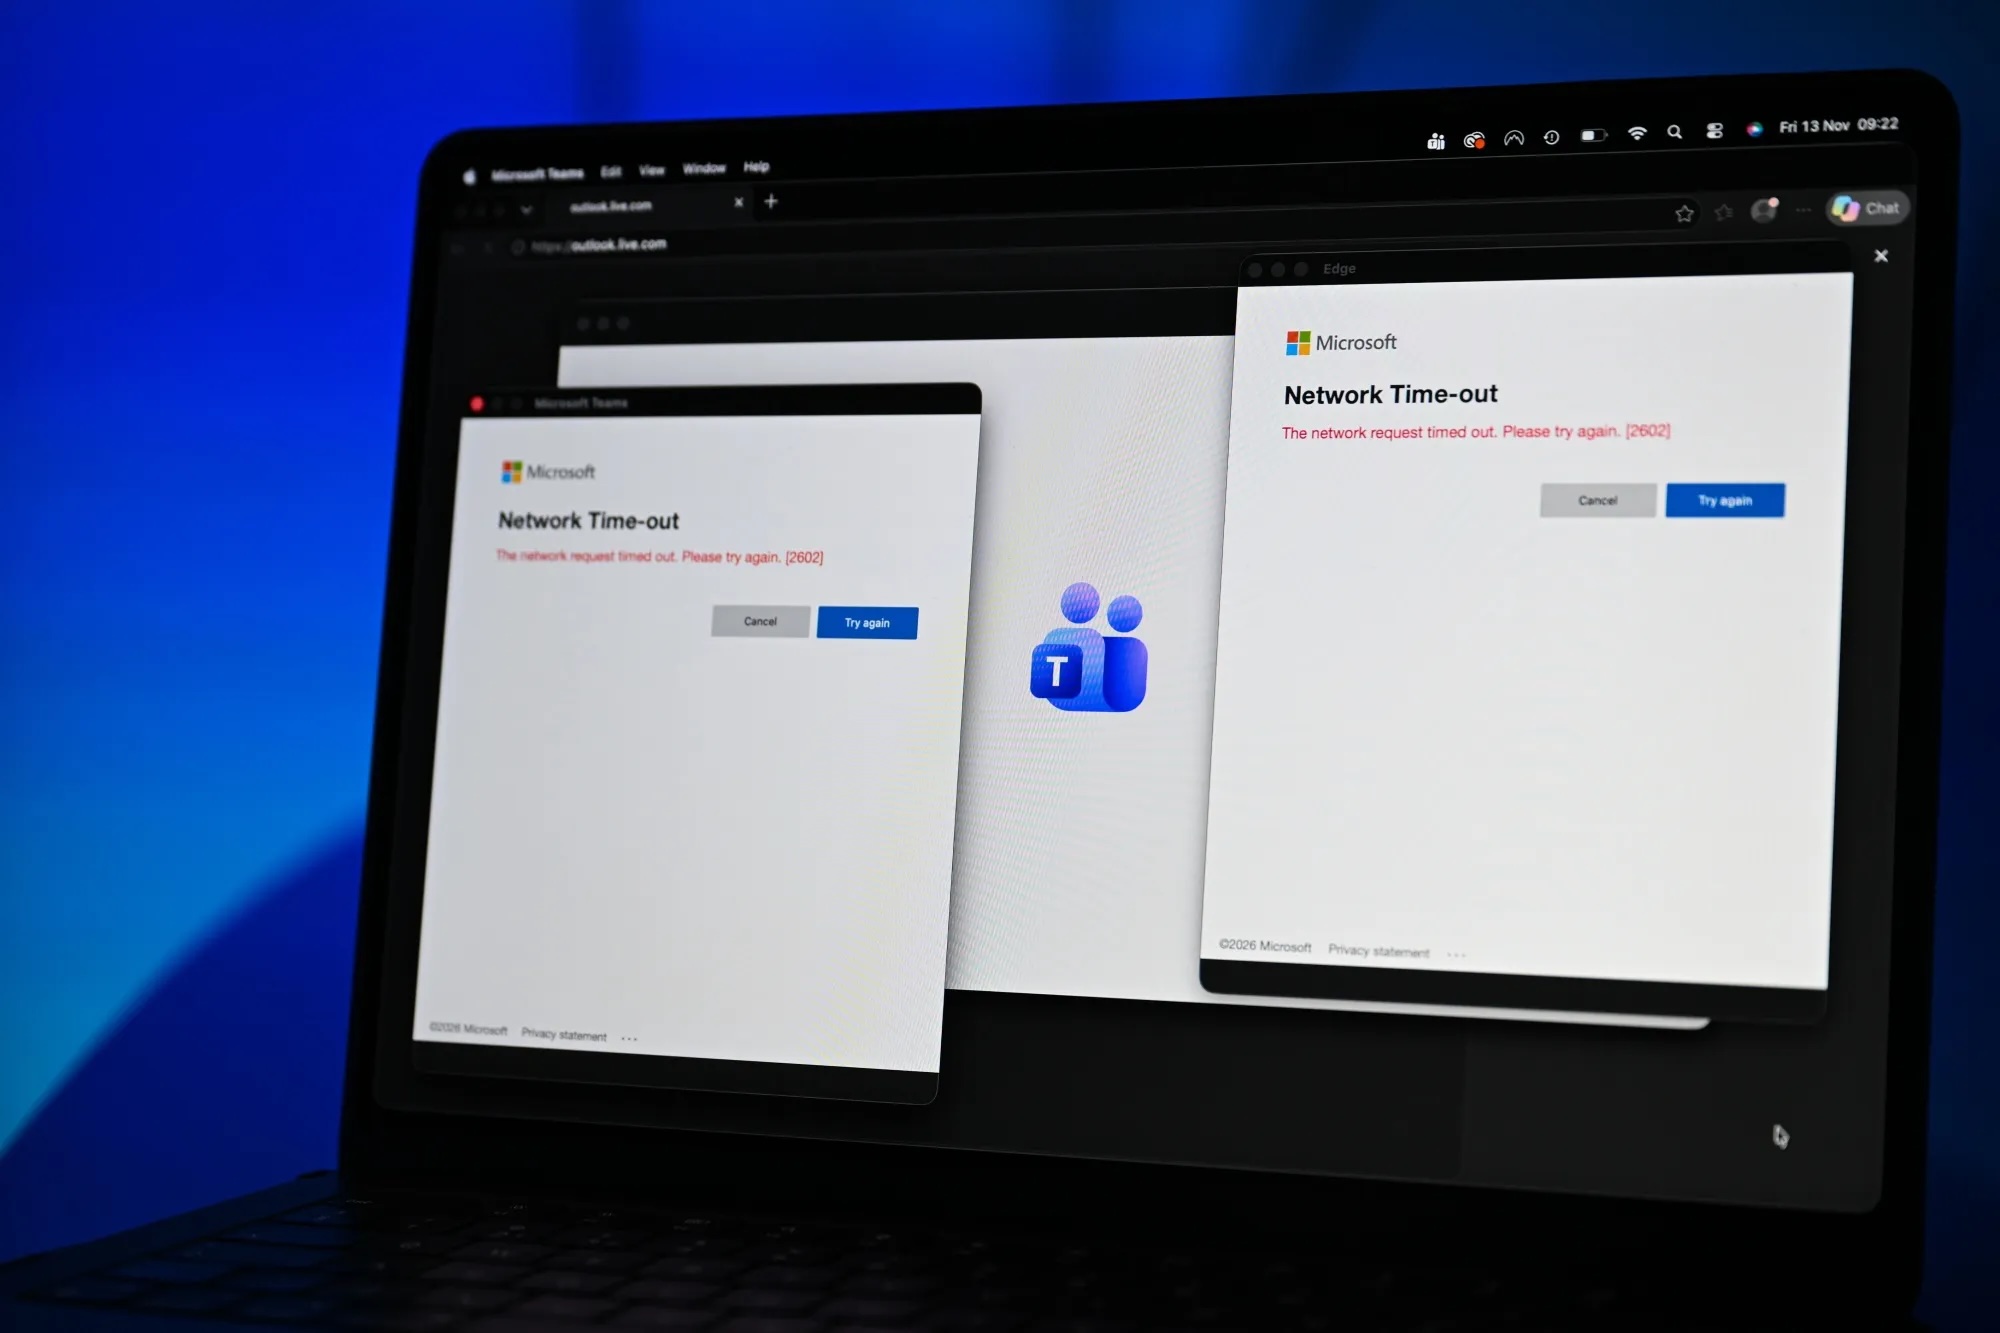
Múlt hét végén súlyos üzemzavarral küzdött a Microsoft 365 platform több szolgáltatása, így elsősorban a vállalati levelezés és a Teams. A cég most közzétette, mi vezetett a csütörtök esetétől legalább péntek délutánig tartó üzemzavarhoz.
Klasszikus láncreakciós folyamat okozta a Microsoft rendszereinek november 12-i globális üzemzavarát, mely csaknem egy napon keresztül tette részben elérhetetlenné vagy lassította le a Microsoft 365 platformhoz tartozó szolgáltatások jelentős részét, beleértve az Exchange Online-t és a Teams-t.
A vállalat által közzétett előzetes incidensjelentés (Post-Incident Report, azaz PIR) legfontosabb megállapítása, hogy a múlt hét végi összeomlást nem egyetlen hibforrás okozta, hanem három, egymást erősítő jelenség, mely végül bedöntötte az egész rendszer működését, ráadásul a helyreállítást is alaposan megnehezítette.
A három kiváltó ok közül az első egy Windows-javításhoz köthető hibás működés volt, melyet kifejezetten csak a Microsoft 365 hálózati átjáróihoz készítettek. Ennek terítése már júliusban megkezdődött és a komponens mintegy három hónapig nem okozott semmilyen problémát, ám az egyik folyamat paradox módon éppen az újabb, több processzormaggal rendelkező szervereknél váratlanul túlterhelte a CPU- és memóriakapacitást.
Másodszor, a leállást megelőzően tizenöt órával a megnövekedett terhelés miatt a Teams forgalmát átterelték az egyik alternatív átjáróról az elsődleges gateway-re, mely az Exchange Online-t is kiszolgálja. Bár ez rutineljárásnak számít, mindez megnövelte a hálózati átjárók terhelését és megváltoztatta a forgalmuk jellegét is.
Az agent és a mérnök is azt csinálja, amiben jó - így dolgozik a megújult Mito (x) A Mito a nyárra összevonta négy üzletágát a nagyvállalati szoftverfejlesztés kihívásaira válaszul.
Harmadszor mindezt tetézte, hogy egy előző napi, a fentitől teljesen független probléma miatt a hálózati átjárók szerverkapacitásának közel 14 százaléka eleve nem állt rendelkezésre. A kapacitás helyreállításán ismét csak rutinszerűen dolgoztak a mérnökök, a szolgáltatás ráadásul akkora ráhagyással működött, hogy egy ekkora kapacitáskiesésnek önmagában semmilyen problémát nem kellett volna okoznia.
A fentiek azonban együttesen elindítottak egy olyan láncreakció-szerű folyamatot, melyben a rendszer a túlterhelődött és az összeomlott szerverek forgalmát még működő szerverekre irányította át, melyek aztán ugyanabból a szoftverhibából eredően idővel szintén nem válaszoltak.
A PIR szerint mindez kevesebb mint két óra alatt az infrastruktúra jelentős részére átgyűrűzött, volt olyan momentum, amikor a szerverek 80 százaléka nem válaszolt.
A lassú helyreállításra az adhat magyarázatot, hogy az újraindított szerverekre azonnal hatalmas terhelés zúdult, az automatizált helyreállítási folyamatok pedig nem voltak felkészülve arra, hogy ilyen nagyságrendű, egyidejű szerverkiesést kezeljenek. Mivel a hiba hónapok óta ott volt a rendszerben, ezért a szokásos visszaállítási mechanizmusok sem segítették a gyors helyreállítást, végül egy vészfrissítést kellett telepíteni a forgalomból fokozatosan kivont szerverekre, melyeket fokozatosan helyeztek újra terhelés alá - áll az incidensjelentésben.
A Microsoft több intézkedéssel igyekszik a jövőbeni hasonló eseteket kiküszöbölni, így visszaállította a korábban működő kapcsolatkezelési kódot, megnövelte a rendelkezésre állási kapacitást, kiegészítő monitorozást vezetett be, új korlátozásokat épített be a forgalomelosztásba és megnövelte az e-mailek kézbesítési időablakát, hogy a késő üzenetek ne vesszenek el.
A Microsoft a végleges incidensjelentést és a részletesebb javítóintézkedések felsorolását november 20-ra ígérte.